Las 8 cosas que revisar antes de culpar a la base de datos

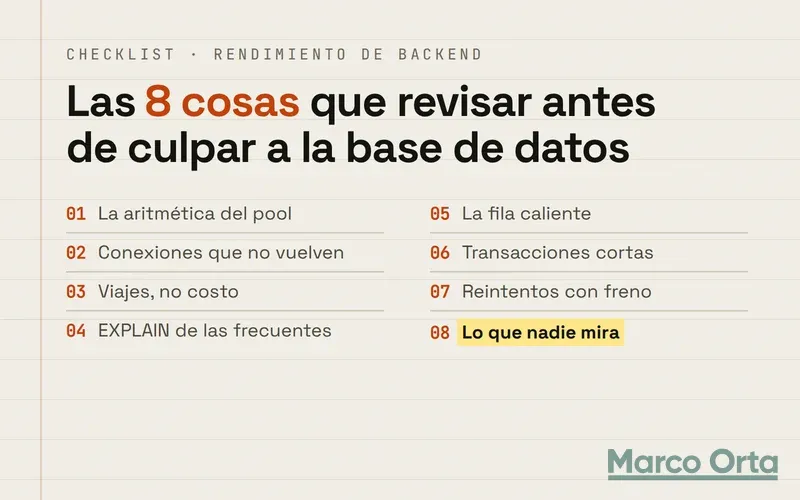
Tabla de Contenidos
«La base de datos va lenta.» Es el diagnóstico más repetido del backend, y en mi experiencia es el correcto menos de la mitad de las veces. La base es el componente más fácil de culpar porque es donde el síntoma aparece: los tiempos suben, las conexiones se agotan, el dashboard se pone rojo. Pero el síntoma casi nunca vive donde vive la causa.
El mejor ejemplo reciente lo publicó Shopify Engineering en agosto de 2026: para aguantar un Black Friday con pico de 5.1 millones de dólares por minuto, movieron las reservas de inventario de Redis a MySQL. Y el remate del artículo es la lección: cuando por fin miraron con calma, el cuello de botella nunca fueron las queries de reservas, sino el agotamiento de conexiones en otras partes del checkout — partes que nadie había optimizado porque nunca habían sido las primeras en topar el límite. Limpiar eso quitó el 50% de las lecturas y un tercio de las transacciones de la base primaria.
Esta es la checklist que recorro, en orden, antes de aceptar que «es la base». Cada punto trae cómo comprobarlo en MySQL y en PostgreSQL. Son las 8 cosas; guárdala para el próximo incidente.
1. La aritmética del pool de conexiones
Antes de mirar una sola query, haz la multiplicación: ¿cuántas conexiones puede llegar a abrir tu aplicación, y cuántas aguanta el servidor?
workers × conexiones por worker > max_connections → ahí está tu incidente
Con 20 workers de PHP-FPM y una conexión por request son 20. Pero con 8 pods de Node y un pool de 10 son 80. Y con funciones serverless, cada ejecución concurrente es una conexión nueva: un pico de tráfico se traduce directo en un pico de conexiones, y la base rechaza justo cuando más se le pide.
-- MySQL
SHOW VARIABLES LIKE 'max_connections';
SHOW STATUS LIKE 'Threads_connected';
SHOW STATUS LIKE 'Max_used_connections';

-- PostgreSQL
SHOW max_connections;
SELECT count(*) FROM pg_stat_activity;
Si Max_used_connections está pegado a max_connections, no tienes un problema de queries: tienes un problema de aritmética. La respuesta no suele ser subir el límite, sino poner un pooler en medio (ProxySQL, PgBouncer) o bajar el pool por worker.
2. Las conexiones que no vuelven
Lo segundo es ver qué están haciendo las conexiones ocupadas. La sorpresa habitual: nada.
-- MySQL: ¿cuántas duermen?
SHOW PROCESSLIST;

-- PostgreSQL: el estado que duele
SELECT state, count(*)
FROM pg_stat_activity
GROUP BY state;
Un ejército de conexiones en Sleep / idle significa pools sobredimensionados o conexiones persistentes que nadie recicla. Y el estado idle in transaction de Postgres es peor: una transacción abierta que no avanza retiene locks y estorba al autovacuum aunque no ejecute nada. Eso es un leak en el código — un beginTransaction sin commit en alguna rama, un manejador de errores que no cierra.
3. El número de viajes, no el costo del viaje
El clásico N+1: la página no es lenta porque una query sea cara, sino porque hace doscientas baratas. Con 1 ms de latencia de red por ida y vuelta, 200 queries son 200 ms de puro viaje, con la base perfectamente sana.
La señal en producción: tiempos de página altos con EXPLAIN impecables. La confirmación, contar las queries de un solo request — el log del ORM en desarrollo, o treinta segundos de general_log si hay que verlo en caliente. En Laravel, Model::preventLazyLoading() en local convierte cada N+1 en una excepción antes de que llegue a producción; en otros stacks, el contador de queries por request del APM cumple el mismo papel.
La solución es de código, no de base: eager loading, un WHERE IN, o una query con JOIN donde había un bucle.
4. EXPLAIN de las frecuentes, no de la más lenta
El slow query log ordena por duración, y eso engaña: la query de 4 segundos que corre una vez por hora molesta menos que la de 20 ms que corre 500 veces por segundo. La primera es un susto; la segunda es tu CPU.
-- PostgreSQL: ordena por tiempo TOTAL acumulado
SELECT query, calls, total_exec_time, mean_exec_time
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 5;
En MySQL, pt-query-digest sobre el slow log (con umbral bajado) hace el mismo ranking. Haz EXPLAIN de esas cinco — las de más tiempo acumulado — y busca lo de siempre: escaneos completos, índices que no se usan porque la columna va envuelta en una función, ORDER BY sin índice con LIMIT pequeño.
5. La fila caliente
Cuando todo el mundo escribe sobre la misma fila, no hay índice que ayude: los locks se forman en fila india. Los sospechosos son siempre los mismos: un contador global, el stock de un producto en oferta, el registro de un rate limit, el saldo de una cuenta compartida.
-- MySQL: transacciones esperando locks
SELECT * FROM performance_schema.data_lock_waits;
SHOW ENGINE INNODB STATUS;  -- sección TRANSACTIONS

-- PostgreSQL
SELECT * FROM pg_locks WHERE NOT granted;
El patrón de Shopify para esto es elegante: en vez de una fila por artículo con una columna de cantidad, una fila por unidad. Reservar 3 unidades es tomar 3 filas libres con SELECT ... FOR UPDATE SKIP LOCKED — las transacciones ya no pelean por la misma fila, porque ya no hay una misma fila.
6. Transacciones que abrazan I/O externo
Una transacción debe durar milisegundos. Si dentro de ella hay una llamada HTTP a un tercero, la duración de tu transacción pasa a depender del timeout de otra empresa — y mientras tanto retiene sus locks y su conexión.
-- MySQL: transacciones vivas y desde cuándo
SELECT trx_id, trx_started, trx_query
FROM information_schema.innodb_trx
ORDER BY trx_started;

-- PostgreSQL: la más vieja
SELECT pid, now() - xact_start AS dur, state, query
FROM pg_stat_activity
WHERE xact_start IS NOT NULL
ORDER BY dur DESC;
La regla es simple y se audita con un grep: nada de red dentro de una transacción. Se cobra fuera, se escribe dentro; o se escribe con un estado intermedio y un job termina el trabajo.
7. Los reintentos que multiplican
Cuando la base se pone lenta, cada capa con reintentos automáticos — el driver, el ORM, el HTTP client del frontend, el usuario dándole F5 — multiplica la carga exactamente en el peor momento. La base va al 90%, los timeouts saltan, todo el mundo reintenta, y el 90% se vuelve 300%. El incidente ya no es la query: es la tormenta.
Qué revisar, capa por capa: que el timeout del cliente sea menor que el del servidor (si el cliente corta antes de que la base termine, la query sigue corriendo huérfana y encima llega el reintento); que los reintentos tengan backoff exponencial con jitter; y que las operaciones de escritura no se reintenten a ciegas si no son idempotentes.
8. Lo que nunca ha sido optimizado
El punto que resume el caso Shopify. Su sistema de reservas estaba afinadísimo — era la parte que todos miraban. Lo que los estaba matando era el resto del checkout: queries y conexiones en partes «aburridas» que nadie había tocado nunca, porque nunca habían sido el cuello de botella.
Cuando un sistema escala, el límite aparece por definición en el lugar que nunca lo había sido — es decir, en el lugar que nadie ha mirado. Así que la última pregunta de la checklist es incómoda pero barata: ¿qué partes de este flujo tocan la base y no aparecen en ningún dashboard? Empieza por ahí. A Shopify, limpiar esas partes le quitó la mitad de las lecturas de la primaria sin tocar el sistema «lento».
La checklist, para llevar
- Aritmética del pool: workers × pool vs
max_connections. - Conexiones dormidas:
Sleep,idle, y el temibleidle in transaction. - Viajes, no costo: cuenta las queries de un request antes de mirar una sola.
- EXPLAIN por tiempo acumulado, no por duración individual.
- Fila caliente: contadores, stock, rate limits.
SKIP LOCKEDy repartir la fila. - Transacciones cortas: nada de HTTP dentro de una transacción.
- Reintentos con freno: timeouts escalonados, backoff con jitter, idempotencia.
- Lo que nadie mira: el próximo cuello está donde nunca ha estado.
Si llegaste aquí desde el video: esto era lo de «Comenta CONEXIONES». Guárdalo — el próximo incidente no avisa. Y si al recorrer la lista resulta que sí era la base… entonces sí, hablemos de índices.
¿Te sirvió? Recibe la próxima por correo
Una vez por semana: qué se rompe al actualizar, IA para desarrolladores y lo que estoy construyendo, con fuentes. Sin spam.
Al suscribirte aceptas nuestro aviso de privacidad.